Catálogo de banco
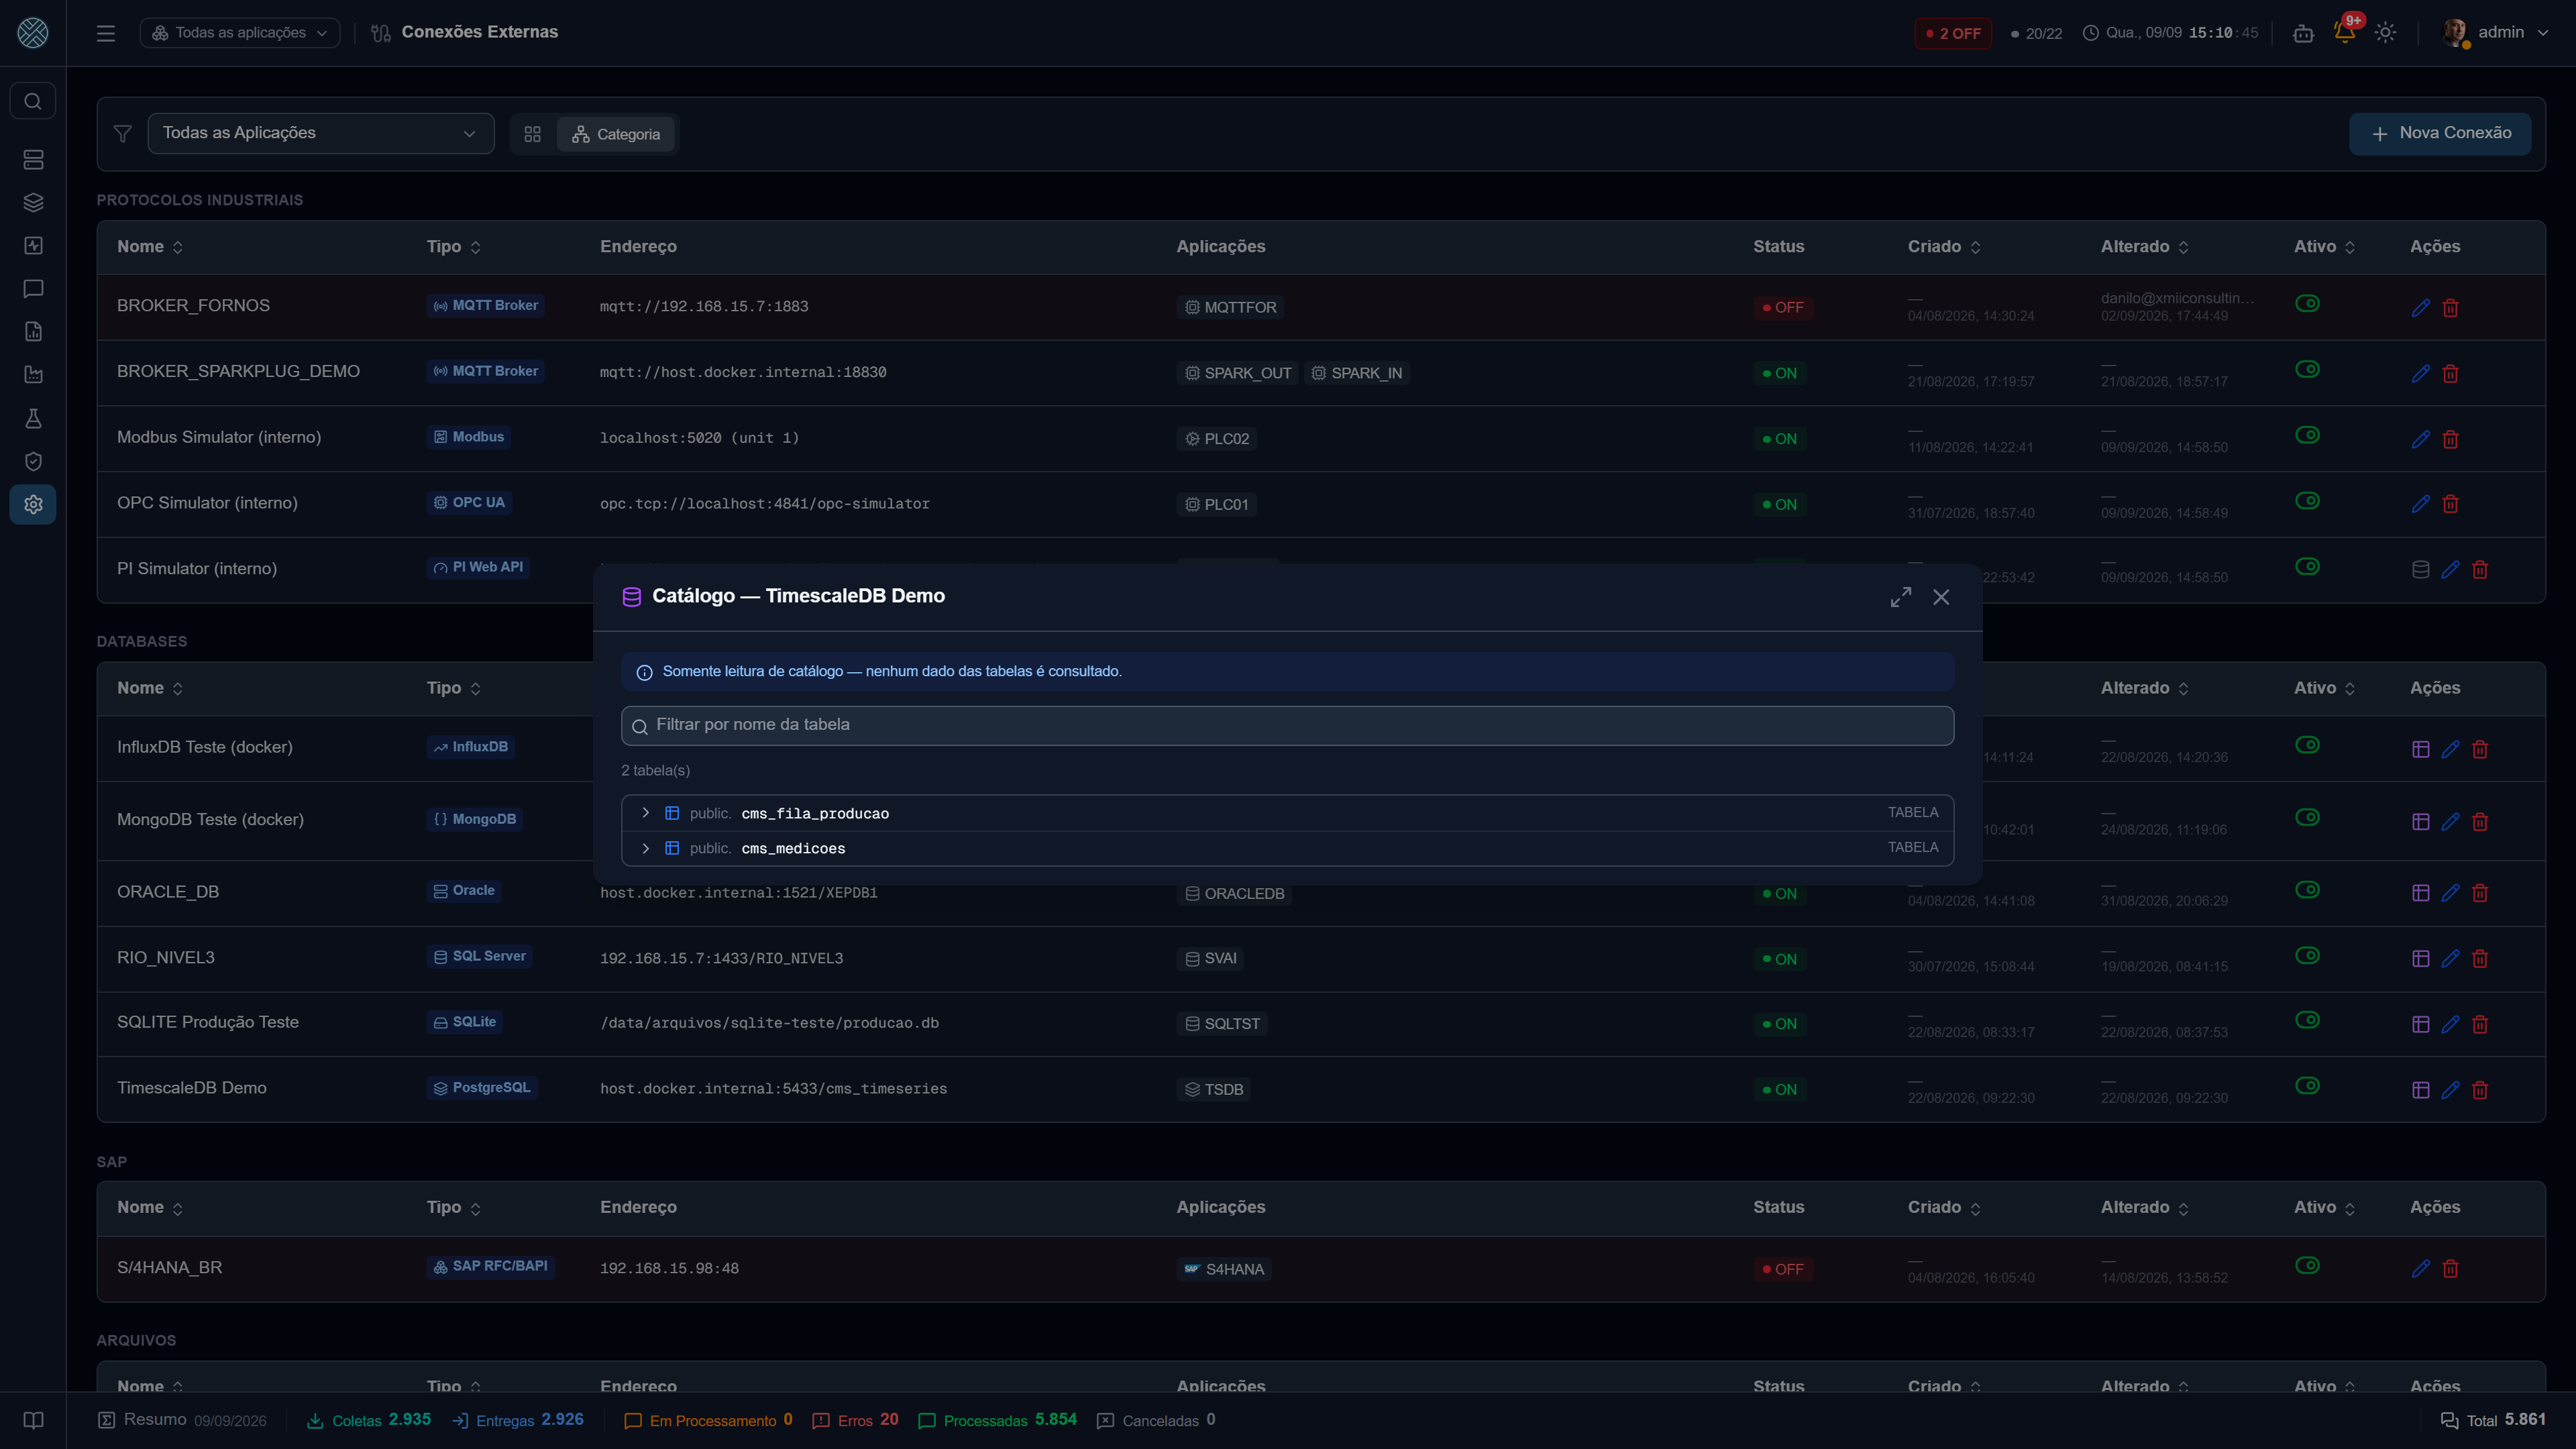
Quando a outra ponta é um banco de dados, a informação necessária para configurar a integração já está lá dentro: os nomes das tabelas, os tipos das colunas, a chave primária. O catálogo lê isso e gera a Coleta e a Entrega prontas.
Abre pelo ícone de tabela, em Conexões Externas (para navegar) ou na linha de uma Aplicação de banco (que já leva a Aplicação junto e não pergunta de novo).
Bancos suportados
| Banco | Catálogo mostra | Gera |
|---|---|---|
| PostgreSQL (inclui TimescaleDB) | esquemas, tabelas, views, colunas, chave primária | Coleta e Entrega |
| SQL Server | esquemas, tabelas, views, colunas, chave primária | Coleta e Entrega |
| Oracle | esquemas, tabelas, views, colunas, chave primária | Coleta e Entrega |
| SQLite | tabelas, views, colunas, chave primária | Coleta e Entrega |
| MongoDB | coleções e campos inferidos | Coleta e Entrega |
| InfluxDB | buckets, measurements, tags e fields | Coleta e Entrega |
O catálogo é somente leitura de estrutura — nenhum dado das tabelas é consultado. Com uma exceção honesta, abaixo.
MongoDB é diferente, e a tela avisa. Não existe esquema no MongoDB: a lista de campos é inferida de uma amostra de até 100 documentos da coleção — o que significa que ali o CMS lê dado, sim. E o resultado é uma boa aproximação, não uma verdade: um documento fora da amostra pode ter campo que não aparece na lista.
O que o catálogo esconde, e por quê
Um banco de produção vem cheio de objeto que não interessa. Cada tipo tem sua regra:
- PostgreSQL — esquemas criados por extensão são omitidos. Num banco com TimescaleDB, os
_timescaledb_*respondem por quase toda a lista e soterrariam as tabelas de negócio. - Oracle — os esquemas que o próprio banco marca como dele (SYS, XDB, CTXSYS…) são omitidos. Exceto o esquema do usuário da conexão: conectar como SYSTEM é comum, e sem essa exceção o catálogo voltaria vazio justamente para quem criou a tabela ali.
- SQLite — as tabelas internas
sqlite_*são omitidas. - InfluxDB 3.x — só as tabelas do esquema
iox, que são os measurements de verdade.
O que você escolhe
Ao abrir uma tabela e clicar em Criar Coleta / Entrega, você decide duas coisas independentes: leitura e gravação. Pode marcar uma, outra ou as duas — e o painel destacado mostra em tempo real o que vai ser criado, com o badge de COLETA e de ENTREGA.
Leitura
| Modo | O que gera |
|---|---|
| Não ler | Nada do lado da Coleta |
| Ler periodicamente | Uma Coleta agendada por cron, com filtro e teto de linhas |
| Ler sob demanda | Uma Coleta que sai do agendador e passa a ser chamável por URL |
No modo sob demanda, você marca quais colunas viram Parâmetro de Entrada. Cada uma vira um
filtro obrigatório do WHERE, preenchido por quem chama a API — e a tela mostra a chamada pronta:
POST /api/collect/MES_PEDIDOS_C/MES_LER_PEDIDOS
{ "id": "..." }
A Interface criada nesse modo tica a cada 5 segundos, e não a cada 5 minutos. A Coleta executa na hora da chamada, mas o encaminhamento do que ela trouxe continua saindo no tick da fila — com o intervalo padrão, a resposta chegaria na hora e ficaria parada.
Gravação
| Modo | O que gera |
|---|---|
| Inserir linhas | Uma Entrega com INSERT a partir do payload da mensagem |
| Atualizar linhas pela chave | Uma Entrega com UPDATE, casando pela chave que você escolher |
O UPDATE é oferecido mesmo em tabela sem chave primária declarada — staging, view materializada
e legado costumam não ter PK e mesmo assim ter uma chave lógica que só quem conhece o dado sabe
apontar. Nesse caso a escolha das colunas é obrigatória: o que não se aceita é um UPDATE sem
WHERE, que reescreveria a tabela inteira.
Colunas, filtro, teto e prefixo
- Colunas — quais entram no
SELECTe no comando de escrita. Vazio significa todas. - Filtro — a condição fixa do
WHERE, sem escrever a palavraWHERE. No MongoDB é um objeto JSON; no InfluxDB é a janela de tempo dorange(). - Máximo de linhas por execução — não é conveniência: sem teto, uma Coleta agendada pode trazer a tabela inteira no primeiro tick.
- Prefixo das siglas — o começo do nome de tudo que for criado, sugerido a partir da Aplicação. O nome final continua editável na revisão.
O comando gerado
A revisão mostra o comando que será gravado, antes de gravar. Em todos os dialetos vale a mesma regra de segurança: o payload da mensagem vai como um único parâmetro bindado, e é o banco que extrai os campos. Nenhum valor é concatenado no texto do comando.
| Banco | Leitura | Escrita |
|---|---|---|
| PostgreSQL | SELECT ... LIMIT n | jsonb_array_elements sobre :payload |
| SQL Server | SELECT TOP (n) ... | OPENJSON(:payload) WITH (...) |
| Oracle | SELECT ... WHERE ROWNUM <= n | JSON_TABLE(:payload, '$[*]' COLUMNS ...) |
| SQLite | SELECT ... LIMIT n | json_each + json_extract |
| MongoDB | filtro FIND em JSON | insertOne / updateOne |
| InfluxDB | Flux com range + pivot | line protocol com tags e fields mapeados |
Objeto único e lote passam pelo mesmo comando: se o payload for uma lista, todas as linhas entram de uma vez.
Particularidades que valem saber
Oracle usa MERGE no UPDATE. Não é preferência de estilo: um UPDATE cujo dado de origem é
JSON_TABLE relata as linhas certas como afetadas e grava NULL em todas elas — a correlação com
a tabela alvo funciona no WHERE EXISTS e falha no SET, em silêncio. MERGE é a forma que o
Oracle de fato suporta para escrever a partir de JSON.
MongoDB tem chave e tipo. O campo _id é tratado como chave, e um parâmetro que aponte para um
campo do tipo objectId é convertido para ObjectId na consulta — comparar a string crua nunca
casaria, e a consulta voltaria vazia sem erro nenhum.
InfluxDB gera o caso comum, não o agregado. A Coleta sai como “a janela recente destes fields”,
com pivot para virar uma linha por instante. Média por hora, último valor por equipamento e
companhia dependem de uma intenção que o catálogo não conhece — para isso, escreva o Flux à mão a
partir do que o catálogo mostrou. Os campos gravados saem sempre com tipo AUTO, porque o InfluxDB
fixa o tipo de um field na primeira escrita: gravar um inteiro hoje faria 10.5 ser recusado meses
depois.
Parâmetro de Entrada no InfluxDB só pode ser tag. Filtrar por field compararia o valor medido, que é o oposto de recortar a série.