Catálogo de base de datos
Cuando el otro lado es una base de datos, la información necesaria para configurar la integración ya está ahí adentro: los nombres de las tablas, los tipos de las columnas, la clave primaria. El catálogo lee eso y genera la Colecta y la Entrega listas.
Se abre con el ícono de tabla, en Conexiones Externas (para navegar) o en la fila de una Aplicación de base (que ya lleva la Aplicación consigo y no pregunta de nuevo).
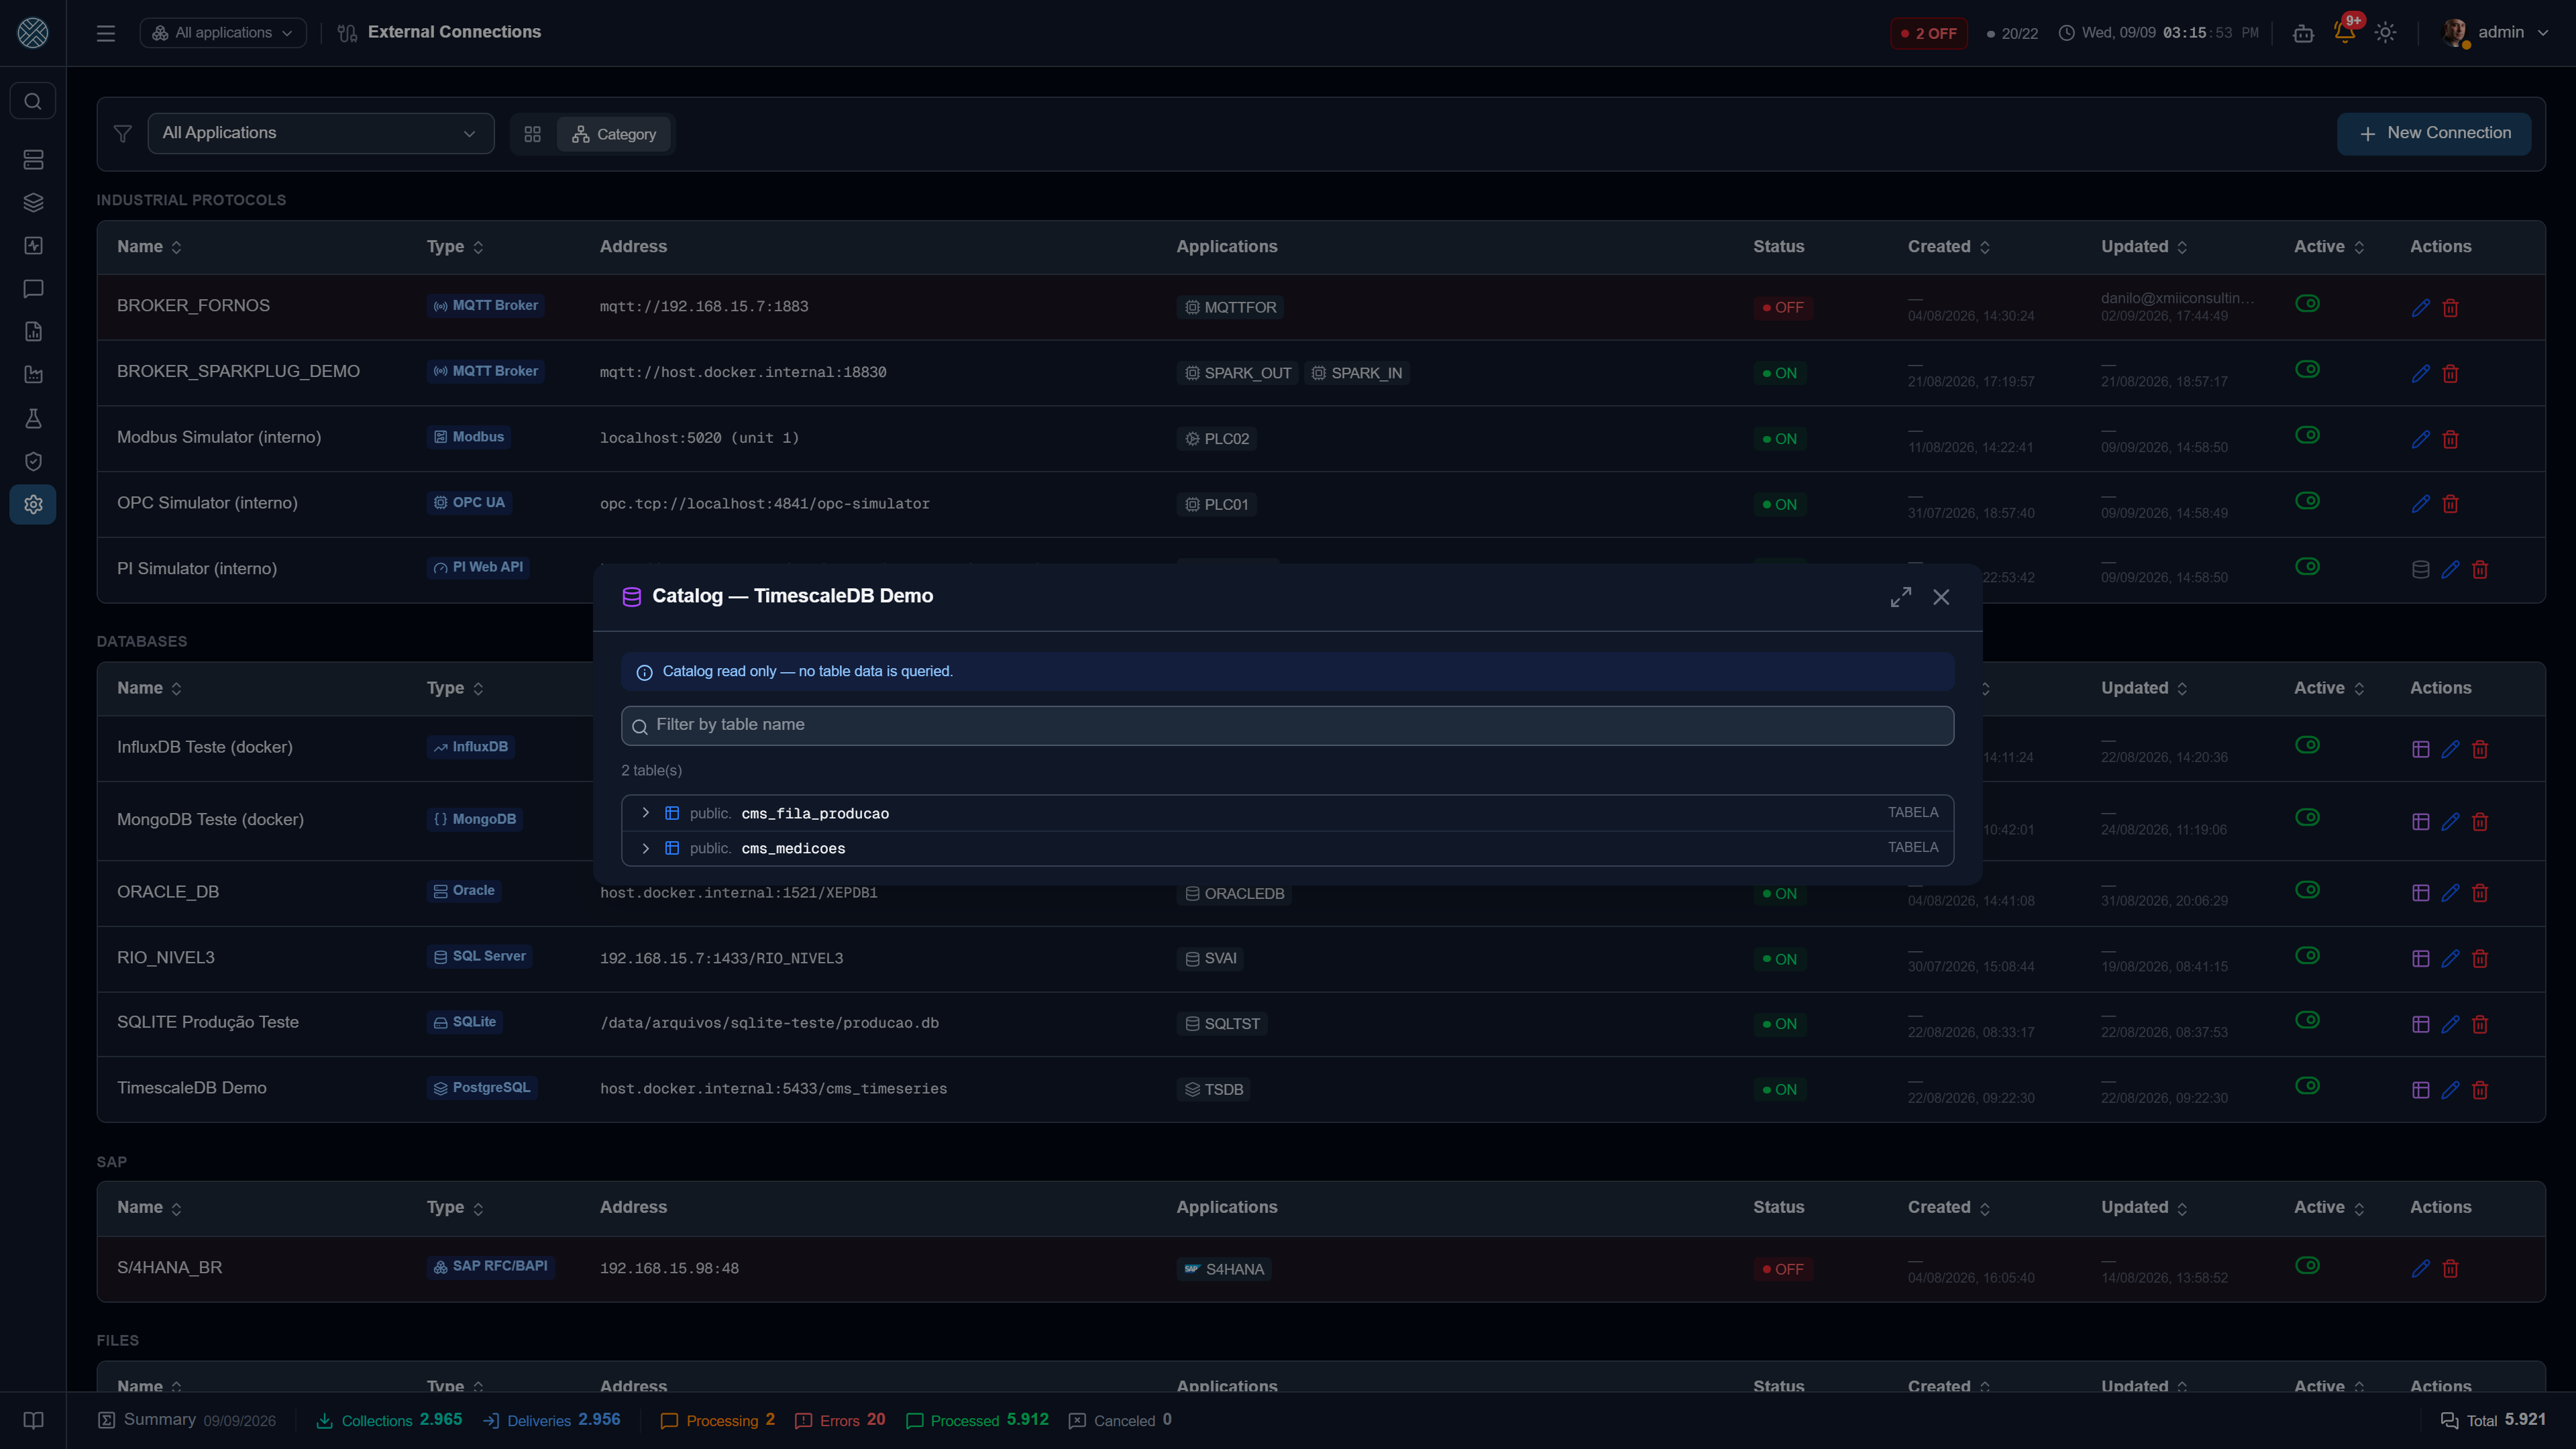
Bases soportadas
| Base | El catálogo muestra | Genera |
|---|---|---|
| PostgreSQL (incluye TimescaleDB) | esquemas, tablas, vistas, columnas, clave primaria | Colecta y Entrega |
| SQL Server | esquemas, tablas, vistas, columnas, clave primaria | Colecta y Entrega |
| Oracle | esquemas, tablas, vistas, columnas, clave primaria | Colecta y Entrega |
| SQLite | tablas, vistas, columnas, clave primaria | Colecta y Entrega |
| MongoDB | colecciones y campos inferidos | Colecta y Entrega |
| InfluxDB | buckets, measurements, tags y fields | Colecta y Entrega |
El catálogo es solo lectura de estructura — ningún dato de las tablas se consulta. Con una excepción honesta, abajo.
MongoDB es diferente, y la pantalla lo avisa. No existe esquema en MongoDB: la lista de campos es inferida de una muestra de hasta 100 documentos de la colección — lo que significa que ahí el CMS sí lee dato. Y el resultado es una buena aproximación, no una verdad: un documento fuera de la muestra puede tener campos que no aparecen en la lista.
Lo que el catálogo esconde, y por qué
Una base de producción viene llena de objetos que no interesan. Cada tipo tiene su regla:
- PostgreSQL — los esquemas creados por una extensión se omiten. En una base con TimescaleDB,
los
_timescaledb_*representan casi toda la lista y sepultarían las tablas de negocio. - Oracle — los esquemas que la propia base marca como suyos (SYS, XDB, CTXSYS…) se omiten. Excepto el esquema del usuario de la conexión: conectarse como SYSTEM es común, y sin esa excepción el catálogo volvería vacío justamente para quien creó la tabla ahí.
- SQLite — las tablas internas
sqlite_*se omiten. - InfluxDB 3.x — solo las tablas del esquema
iox, que son los measurements de verdad.
Lo que usted elige
Al abrir una tabla y hacer clic en Crear Colecta / Entrega, usted decide dos cosas independientes: lectura y grabación. Puede marcar una, otra o las dos — y el panel destacado muestra en tiempo real lo que se va a crear, con el badge de COLECTA y de ENTREGA.
Lectura
| Modo | Qué genera |
|---|---|
| No leer | Nada del lado de la Colecta |
| Leer periódicamente | Una Colecta agendada por cron, con filtro y techo de filas |
| Leer bajo demanda | Una Colecta que sale del agendador y pasa a ser invocable por URL |
En el modo bajo demanda, usted marca qué columnas se vuelven Parámetro de Entrada. Cada una se
vuelve un filtro obligatorio del WHERE, completado por quien llama a la API — y la pantalla
muestra la llamada lista:
POST /api/collect/MES_PEDIDOS_C/MES_LER_PEDIDOS
{ "id": "..." }
La Interface creada en ese modo hace tick cada 5 segundos, y no cada 5 minutos. La Colecta se ejecuta al momento de la llamada, pero el reenvío de lo que trajo sigue saliendo en el tick de la cola — con el intervalo por defecto, la respuesta llegaría al instante y quedaría parada.
Grabación
| Modo | Qué genera |
|---|---|
| Insertar filas | Una Entrega con INSERT a partir del payload del mensaje |
| Actualizar filas por la clave | Una Entrega con UPDATE, casando por la clave que usted elija |
El UPDATE se ofrece incluso en una tabla sin clave primaria declarada — staging, vista
materializada y legado suelen no tener PK y aun así tener una clave lógica que solo quien conoce el
dato sabe señalar. En ese caso la elección de las columnas es obligatoria: lo que no se acepta es un
UPDATE sin WHERE, que reescribiría la tabla entera.
Columnas, filtro, techo y prefijo
- Columnas — cuáles entran en el
SELECTy en el comando de escritura. Vacío significa todas. - Filtro — la condición fija del
WHERE, sin escribir la palabraWHERE. En MongoDB es un objeto JSON; en InfluxDB es la ventana de tiempo delrange(). - Máximo de filas por ejecución — no es comodidad: sin techo, una Colecta agendada puede traer la tabla entera en el primer tick.
- Prefijo de las siglas — el inicio del nombre de todo lo que se cree, sugerido desde la Aplicación. El nombre final sigue siendo editable en la revisión.
El comando generado
La revisión muestra el comando que será grabado, antes de grabar. En todos los dialectos vale la misma regla de seguridad: el payload del mensaje va como un único parámetro bindado, y es la base la que extrae los campos. Ningún valor se concatena en el texto del comando.
| Base | Lectura | Escritura |
|---|---|---|
| PostgreSQL | SELECT ... LIMIT n | jsonb_array_elements sobre :payload |
| SQL Server | SELECT TOP (n) ... | OPENJSON(:payload) WITH (...) |
| Oracle | SELECT ... WHERE ROWNUM <= n | JSON_TABLE(:payload, '$[*]' COLUMNS ...) |
| SQLite | SELECT ... LIMIT n | json_each + json_extract |
| MongoDB | filtro FIND en JSON | insertOne / updateOne |
| InfluxDB | Flux con range + pivot | line protocol con tags y fields mapeados |
Objeto único y lote pasan por el mismo comando: si el payload es una lista, todas las filas entran de una vez.
Particularidades que vale conocer
Oracle usa MERGE en el UPDATE. No es preferencia de estilo: un UPDATE cuyo dato de origen es
JSON_TABLE reporta las filas correctas como afectadas y graba NULL en todas ellas — la
correlación con la tabla objetivo funciona en el WHERE EXISTS y falla en el SET, en silencio.
MERGE es la forma que Oracle sí soporta para escribir a partir de JSON.
MongoDB tiene clave y tipo. El campo _id se trata como clave, y un parámetro que apunte a un
campo del tipo objectId se convierte a ObjectId en la consulta — comparar la cadena cruda nunca
casaría, y la consulta volvería vacía sin error alguno.
InfluxDB genera el caso común, no el agregado. La Colecta sale como “la ventana reciente de
estos fields”, con pivot para volverse una fila por instante. Promedio por hora, último valor por
equipo y compañía dependen de una intención que el catálogo no conoce — para eso, escriba el Flux a
mano a partir de lo que el catálogo mostró. Los campos grabados salen siempre con tipo AUTO,
porque InfluxDB fija el tipo de un field en la primera escritura: grabar un entero hoy haría que
10.5 sea rechazado meses después.
El Parámetro de Entrada en InfluxDB solo puede ser tag. Filtrar por un field compararía el valor medido, que es lo opuesto a recortar la serie.